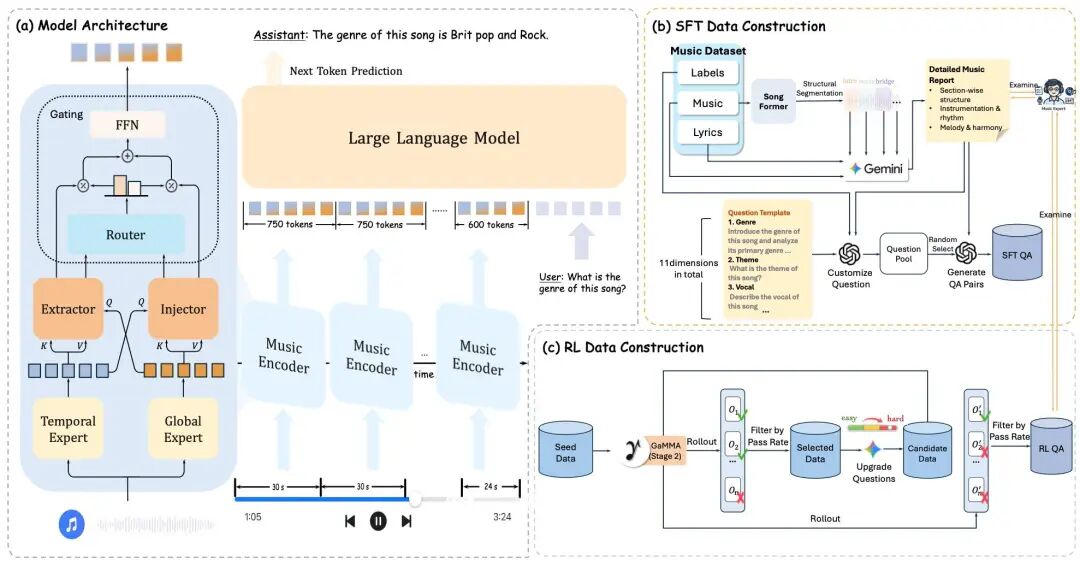
读懂音乐时间线到底有多难?复旦与字节联手打造GaMMA,多模态大模型终于学会“按秒听歌”音乐时序理解一直是多模态大模型的致命短板。复旦联合字节推出GaMMA模型,创新采用双编码器融合网络与GRPO强化学习,让大模型真正读懂音乐时间线。实验表明,它在音乐结构拆解与时序任务上超越Gemini...AI 前沿动态# GaMMA# GRPO强化学习# 多模态大模型4个月前650
CVPR 2026 | 多模态大模型如何看懂物种关系?北大团队提出TARA,层级识别准确率大幅提升北京大学王选所彭宇新团队提出TARA方法,通过生物基础模型对齐表征,显著提升多模态大模型在层级视觉识别中的一致性表现,并大幅增强对未知物种的泛化能力,论文入选CVPR 2026。AI 前沿动态# CVPR 2026# TARA# 北大彭宇新团队4个月前590
「屏幕图灵测试」曝光:大模型 GUI Agent 如何绕过平台检测实现“拟人化生存”多模态大模型驱动的GUI Agent面临平台检测危机,上海交大与CMU团队提出“屏幕图灵测试”与AHB基准,系统剖析原生Agent的机械印记,通过历史匹配、伪动作注入等策略探索拟真度与实用性的帕累托前...AI 前沿动态# AHB基准# GUI Agent# 反检测4个月前570
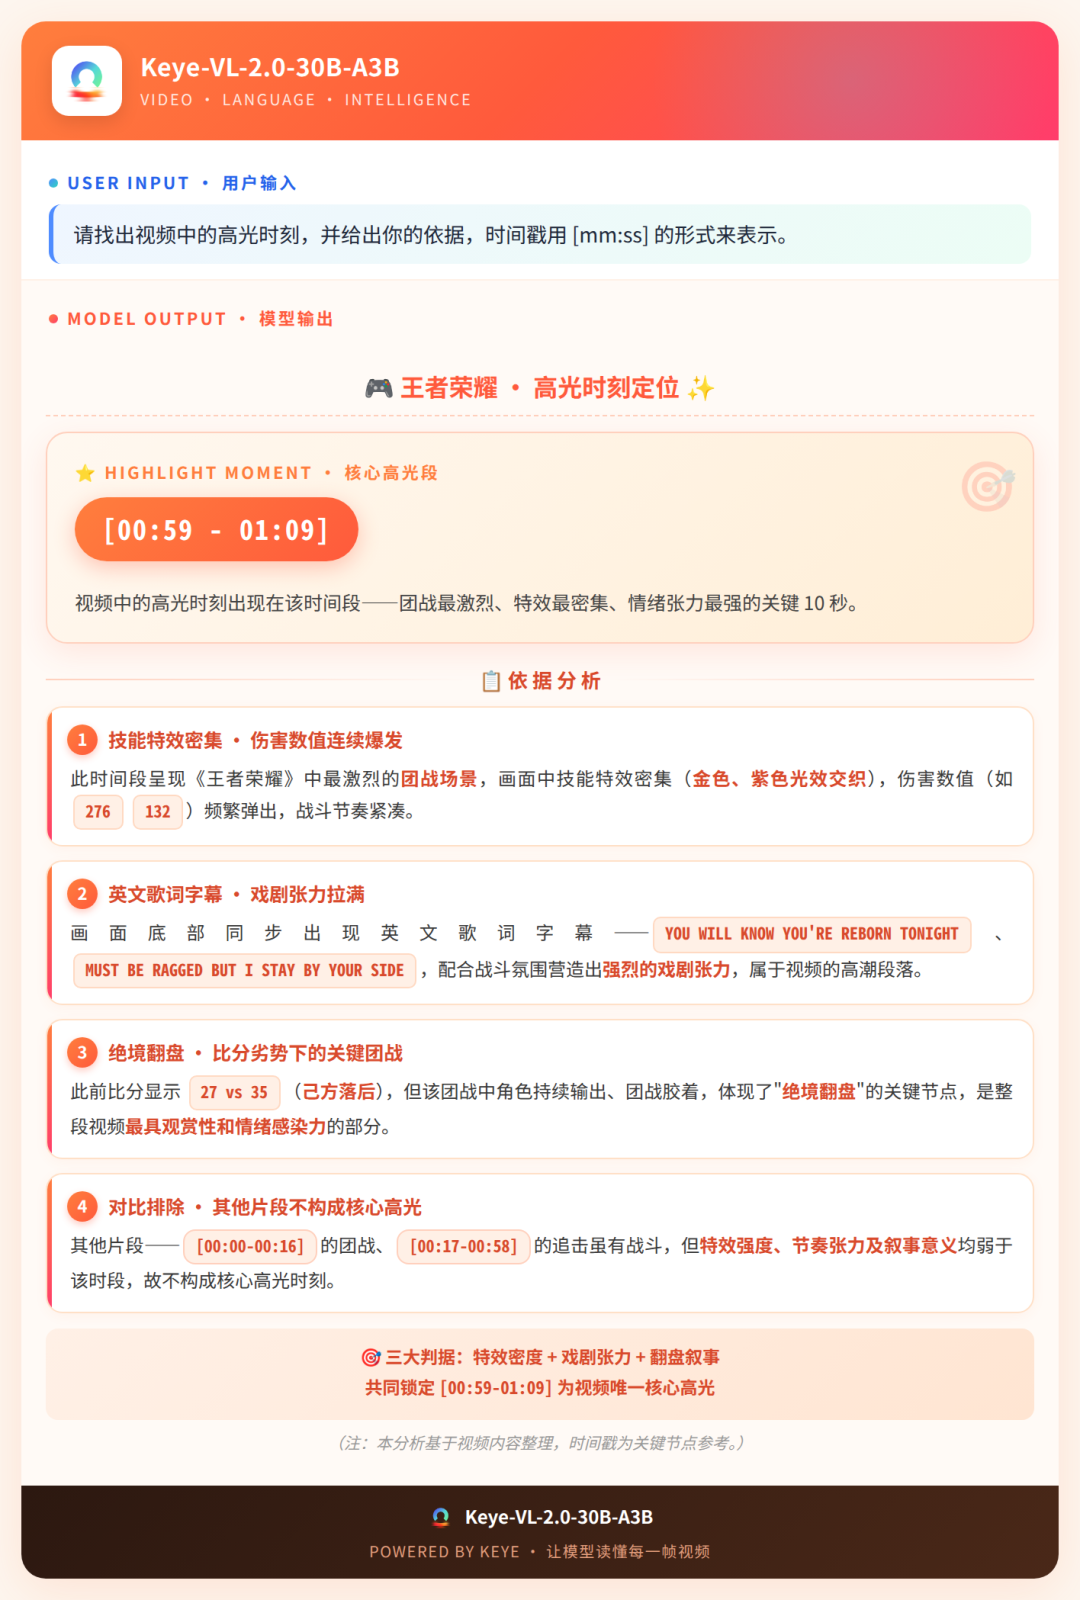
免费开源!快手Keye-VL-2.0-30B大模型上线:手把手教你白嫖256K超长视频理解与代码AgentKeye-VL-2.0-30B-A3B是快手开源的全新一代多模态大模型底座。它引入了DSA机制以极低推理成本支持256K超长上下文,并首次解锁Code与Tool等Agent协作机制,提供优秀的时序因果...AI 前沿动态# Agent# Keye-VL-2.0# 多模态大模型4个月前550
多模态大模型能理解视频笑点吗?v-HUB基准揭秘AI幽默理解的四大短板上海交大等团队发布v-HUB基准,评测7款多模态大模型对无台词搞笑视频的理解力。研究发现模型严重依赖文字描述,难以从视频中直接捕捉动作、声音与反差,幽默解释仍存关键短板。AI 前沿动态# ACL 2026# Gemini# GPT-4o4个月前550
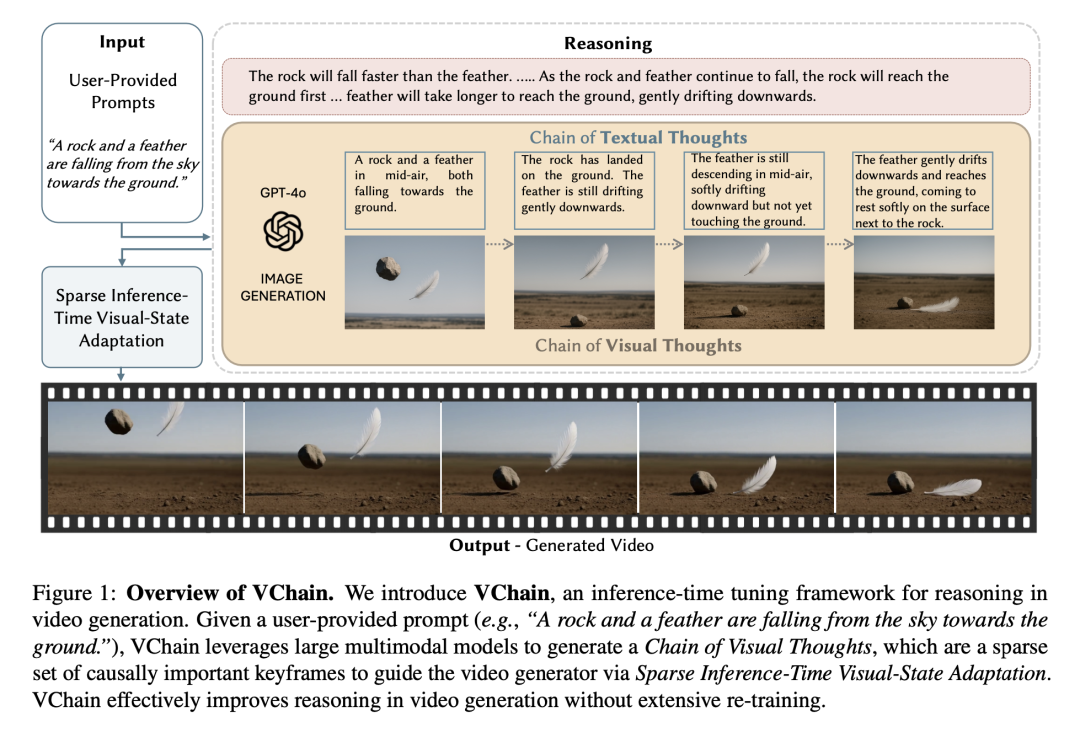
给视频生成装上“物理外脑”:NTU团队提出VChain,用视觉推理解决画面“穿帮”难题视频生成模型常因缺乏物理常识导致画面穿帮。南洋理工大学团队推出VChain框架,首次引入“视觉思维链”机制。该方案利用多模态大模型进行逻辑推演并指导视频生成,在常识与因果规律测评中表现优异,零重训实现...AI 前沿动态# VChain# 多模态大模型# 大模型推理4个月前540
告别视觉幻觉!首个多模态并行思考框架开源:以“宽度”破局,让VLM学会分头行动视觉语言模型在长推理时易发生注意力漂移并产生幻觉。为此,最新研究提出首个并行思考框架Visual Para-Thinker,引入并行注意力与分段学习位置编码机制。实验显示该框架显著提升了多模态模型在视...AI 前沿动态# Visual Para-Thinker# 多模态大模型# 并行思考4个月前540
告别“废话连篇”的推理!浙大等提出Heima框架:大模型用3个隐式Token看懂世界多模态大模型在依靠CoT推理时,文本冗长极易增加硬件解码延迟。为此,浙大等提出Heima推理框架,将复杂的显式步骤压缩成少数隐式思考Token。实测表明,该方案成功在隐空间实现极速探索,不仅免去了海量...AI 前沿动态# CoT压缩# Heima# ICML20264个月前510
AI不再“近视眼”:上交大&蚂蚁提出R2I蒸馏,单次推理实现细粒度感知,速度提升10倍上海交通大学与蚂蚁集团联合提出Region-to-Image Distillation方法,让多模态大模型无需反复缩放即可实现细粒度视觉感知,性能超越Kimi-K2.5等大模型,速度提升10倍。AI 前沿动态# AI视觉# ZwZ# 区域到图像蒸馏4个月前510
CVPR 2026 | 北大彭宇新团队TARA:让多模态大模型看懂物种关系,未知物种也能准确推断北京大学彭宇新团队在CVPR 2026提出TARA方法,通过分类学感知的表征对齐,让多模态大模型学会生物层级结构,大幅提升层级一致性,并实现对未知物种的准确推断。AI 前沿动态# CVPR 2026# TARA# 何胡凌霄4个月前500