
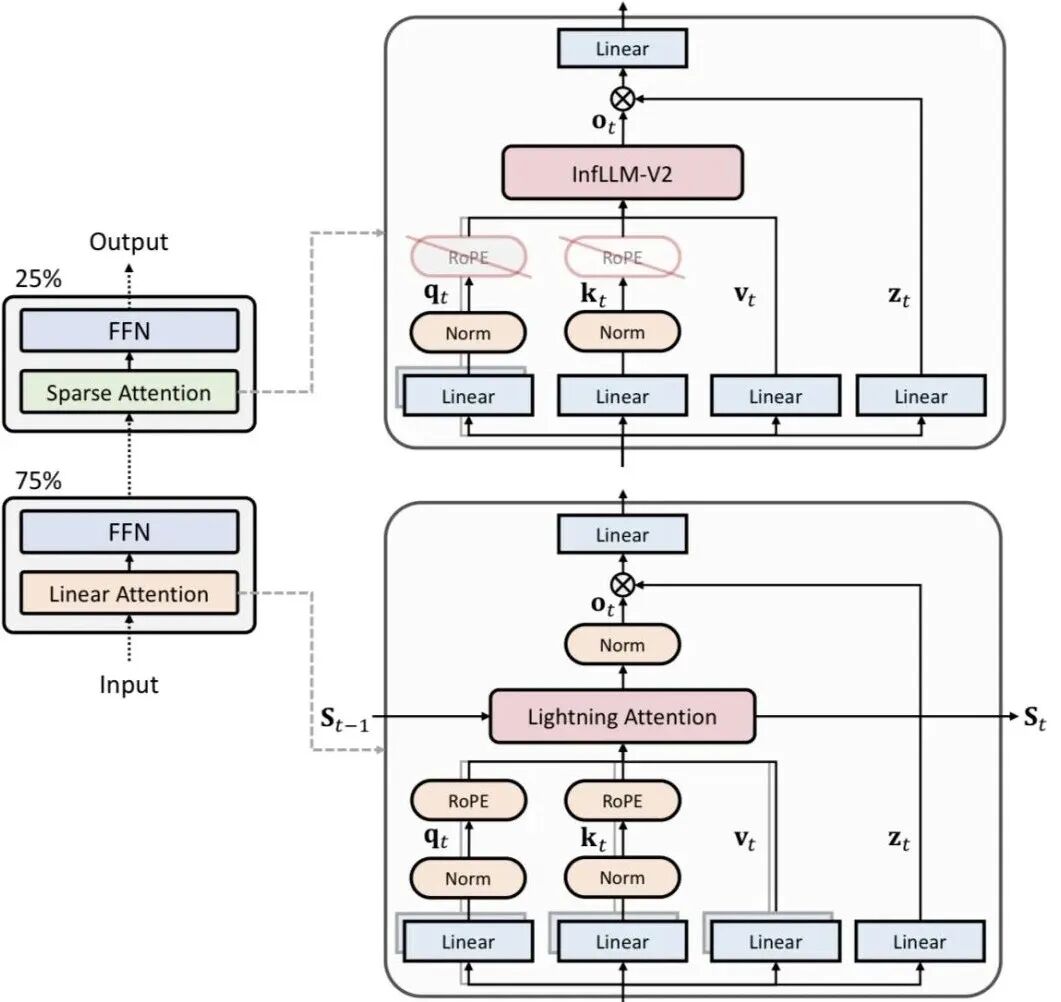
面壁智能发布MiniCPM-SALA:稀疏-线性混合架构,9B模型端侧跑通百万上下文,速度飙升3.5倍
面壁智能推出MiniCPM-SALA,基于稀疏-线性混合注意力架构,仅9B参数即可在消费级GPU上处理百万词元上下文,推理速度达同类模型的3.5倍,长文本能力领先且保持通用性能。


自主研发L5级AI教师,服务5000万学生,这家中国独角兽凭什么入选《时代》最佳发明?
松鼠Ai凭借全球首个多模态智适应教育大模型入选《时代》2025最佳发明。其L5级AI老师已服务5000万学生,实现提分15%-41%,并牵头制定IEEE国际标准,让个性化教育普惠全球。

多步预测总翻车?北大团队揪出MSE两大“原罪”,让损失函数自我进化 | ICLR 2026
北大林宙辰团队在ICLR 2026提出QDF方法,指出传统MSE损失的两个错误先验,并通过元学习让损失函数自适应调整,显著改善多步时序预测的长期误差,无需改动模型结构。

红杉领投数亿元!智元旗下觅蜂科技获融资,解密具身智能「孵化-独立」模式
智元旗下具身智能数据平台觅蜂科技完成数亿元融资,红杉领投。解析智元‘孵化-独立融资’模式及其三大优势。
多跳推理性能飙升20%!Search-R2将纠错纳入策略空间,破解搜索增强推理的长链信用分配难题
腾讯混元、MBZUAI和港中文联合提出Search-R2框架,将纠错纳入强化学习策略空间,有效解决长链搜索推理中的错误传播问题,在多跳推理任务中性能提升超20%,为搜索型智能体提供了更贴近真实失败模式...
AI Agent的“斯坦利时刻”:告别基准高分幻觉,直面职场执行鸿沟
Trainee-Bench通过模拟真实职场,从动态调度、主动探索、持续学习三维度评估AI Agent,结果显示顶尖模型成功率不足35%,并发任务下性能骤降,甚至出现“记吃不记打”的反常现象。

AI不再“近视眼”:上交大&蚂蚁提出R2I蒸馏,单次推理实现细粒度感知,速度提升10倍
上海交通大学与蚂蚁集团联合提出Region-to-Image Distillation方法,让多模态大模型无需反复缩放即可实现细粒度视觉感知,性能超越Kimi-K2.5等大模型,速度提升10倍。

ICLR 2026 | 清华刘洋团队震撼发现:8B小模型问诊吊打70B大模型,医疗AI的真正救命能力原来不是背书!
清华刘洋团队在ICLR2026发表重磅论文,提出DOCTOR-R1框架,用8B小模型在动态问诊中超越70B大模型,揭示医疗AI的真正瓶颈在于提问策略而非知识规模。

原力灵机范浩强:评判机器人好坏的唯一指标,是它多久能回本
原力灵机联合创始人范浩强在访谈中提出,评判机器人好坏的唯一指标是它多久能回本。本文深入探讨了具身智能真实场景的落地挑战,以及原力灵机如何通过开源模型与硬件闭环,从百里挑一走向无限泛化。
AI从“做事”进化到“规划人生”:NOOK创始人详解如何用玄学+游戏化打造“人生外挂”
NOOK是一款融合玄学与游戏化的AI人生规划应用,通过Life Copilot将目标拆解为每日任务,用数值反馈驱动年轻人行动。创始人许清岚详解从“做事”到“规划人生”的AI进化路径。